
如题
主要问题:千万级别处理起来会不会崩溃?
主要是去重
谢谢
如题
主要问题:千万级别处理起来会不会崩溃?
主要是去重
谢谢
 |
jdhaoJul 15, 2019 via Android
1
自己做一个然后试一下不就知道了
|
 |
yedantenJul 15, 2019 via Android
2
得看业务情况啊,不知道你后续的处理是要做哪些操作,否则只是去重,最简单粗暴的转换为 set 就完事了
|
 |
momo1999Jul 15, 2019
3
推荐用 64 位 Python,加内存就是了。
|
 |
lithiumiiJul 15, 2019
4
list(set(li)
崩溃了就是你电脑不行!(滑稽 |
 |
5
既然都能打算一次性把 4000 个元素放到一个 list 里面操作,不如就直接再导入 Excel 去重:doge:。
|
 |
chengxiaoJul 15, 2019
6
这种建议直接上 MongoDB 然后设置索引唯一去重
|
 |
nuttingJul 15, 2019
7
内存里的操作怕啥,比数据库强多了,随便搞
|
 |
ipwxJul 15, 2019
8
In [4]: N = 10**8
In [5]: arr = np.random.randint(0, N, size=N) In [6]: len(arr) Out[6]: 100000000 In [7]: %timeit set(arr) 36 s ± 122 ms per loop (mean ± std. dev. of 7 runs, 1 loop each) 给你一个时间作参考。。。 |
 |
ytmsdyJul 15, 2019
9
先分段排序,然后去重。
|
 |
10
几千万的数据,一台电脑运行,有可行性吗?
|
 |
UniverseJul 15, 2019 via Android
12
看精度要求,不高的话布隆过滤器可以一试
|
 |
pcdRobJul 15, 2019
13
几千万而已 洒洒水啦
|
 |
fuxiuyinJul 15, 2019
14
首先,这 4 千万个元素肯定是要便利一遍的,除非你的数据有什么特殊的规律。
其次,要看这 4 千万存在哪,内存?文件?网络? 最后,如果没有优化空间不可避免的要对 4 千万数据过一遍那就看想优化内存还是想优化时间了,不过最快可能也就是楼上 8 楼给的。 |
 |
mengzhuoJul 15, 2019
15
4 千万 uint32,最大也就 40M 搞定了…… O ( N )操作而已
|
 |
dji38838cJul 15, 2019
16
这样都不肯用 pandas 吗?
|
 |
ruandaoJul 15, 2019
17
布隆过滤器
|
|
ruandaoJul 15, 2019
18
想了想, 好像不需要
千万,也就 MB 级别吧 |
 |
janxinJul 15, 2019
19
数据都不说一下怎么分情况处理。
这种统一建议 list(set(data)) |
 |
misaka19000Jul 15, 2019
21
不是,你也说一下你每条数据多大啊,每条数据 1kb 和每条数据 10mb 当然不一样
|
 |
vincenttoneJul 15, 2019
22
既然 4 千万个元素能放进数组里,说明你内存就够用,去重就是了,就看算法对内存的使用和耗费的 cpu 时间了。
|
 |
flyingghostJul 15, 2019
23
4kw 个 int,160M,可以直接放内存。
设计一个分布尽可能均匀的散列函数(这一步不太确定我不是搞数学的。瞎拍一个 md5(obj)//4kw 的算法不知道效果怎么样?) 遍历每个 obj 求 hash,把 obj 的 index 放在对应的桶里。 如果桶里已有元素( hash 冲突),单独放在另一个冲突列表里。 对于冲突列表里的每个冲突 hash,遍历并精确对比每个 obj,从源数据集删除完全相同的 obj。 稍微注意一下 getObj(index)的 O(1)复杂度,理论上可以应对任意量的数据了。 |
 |
princelaiJul 15, 2019
24
@ipwx #8 只替换最后一步
%timeit np.unique(arr) 11.4 s ± 401 ms per loop (mean ± std. dev. of 7 runs, 1 loop each) |
 |
dyllanwliJul 15, 2019
25
|
 |
scalaerJul 15, 2019
26
看看 bitmap
|
 |
lihongjie0209Jul 15, 2019
27
@mggis0or1 bitmap 对于非数字型的元素无法支持, 还是用布隆过滤器吧
|
 |
reusJul 15, 2019
28
你这水平,处理什么都会崩溃
自己不会试验吗 要问人,又不说清楚细节 |
 |
limuyan44Jul 15, 2019 via Android
29
讨论这么多写个代码就这么难吗也没几行啊
|
 |
NullErroJul 15, 2019
30
想在内存跑的话,简单直接暴力的就是用 set, 推荐布隆过滤器;每个元素比较大的话可以考虑 mr,spark 或者其他分布式计算框架
|
 |
arrow8899Jul 15, 2019
31
首先你要清楚数据的特征啊 整形?浮点数?短字符串?超长字符串?数据分布?重复概率?这些都会影响去重的效率!!!
V2EX √ 动手实践 × |
 |
changs1986Jul 15, 2019
32
bloomfilter ?
|
 |
thedogJul 15, 2019
34
bitmap+1
|
 |
shm7Jul 15, 2019 via iPhone
35
试试 numpy 吧,python list 遍历会检查类型,每次都会。
|
 |
HamnibaJul 15, 2019
36
@flyingghost #23
你这个就是 Hash Table 的思想,getObj(index) 是 O(1),但是求一遍 hash 还是得 O(n) 啊。 |
 |
smdbhJul 15, 2019
37
天天 4 千万,和每月,每年是有区别的。
但是,其实也没多大区别 |
 |
GooeeuJul 15, 2019
38
Bloom Filter
|
 |
sazimaJul 15, 2019
39
list(set(item))
|
|
sazimaJul 15, 2019
40
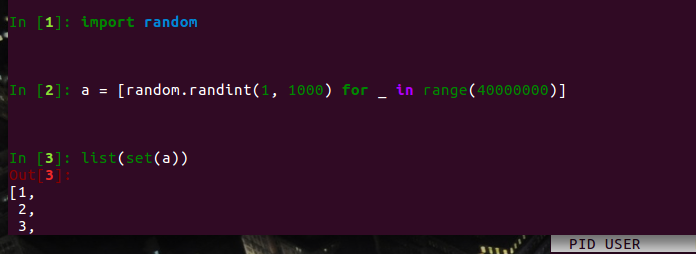 粗略的感觉,耗时不到一秒... 也可能不到 0.5.
|
|
sazimaJul 15, 2019
41
不好意思我的数太简单了 -__-
|
 |
skinnyJul 16, 2019
42
没有元素类型、数据大小信息,更没有电脑内存的信息,就直接问 Python 能不能,别人就只能瞎猜随便说了。
还有,千万不要用 C、C++、C#,甚至 Java 之类的语言的设计和使用经验来估计 Python 的内存用量,到时候如果楼主的电脑内存不够大,估计要死机。 |
 1

 Select Language